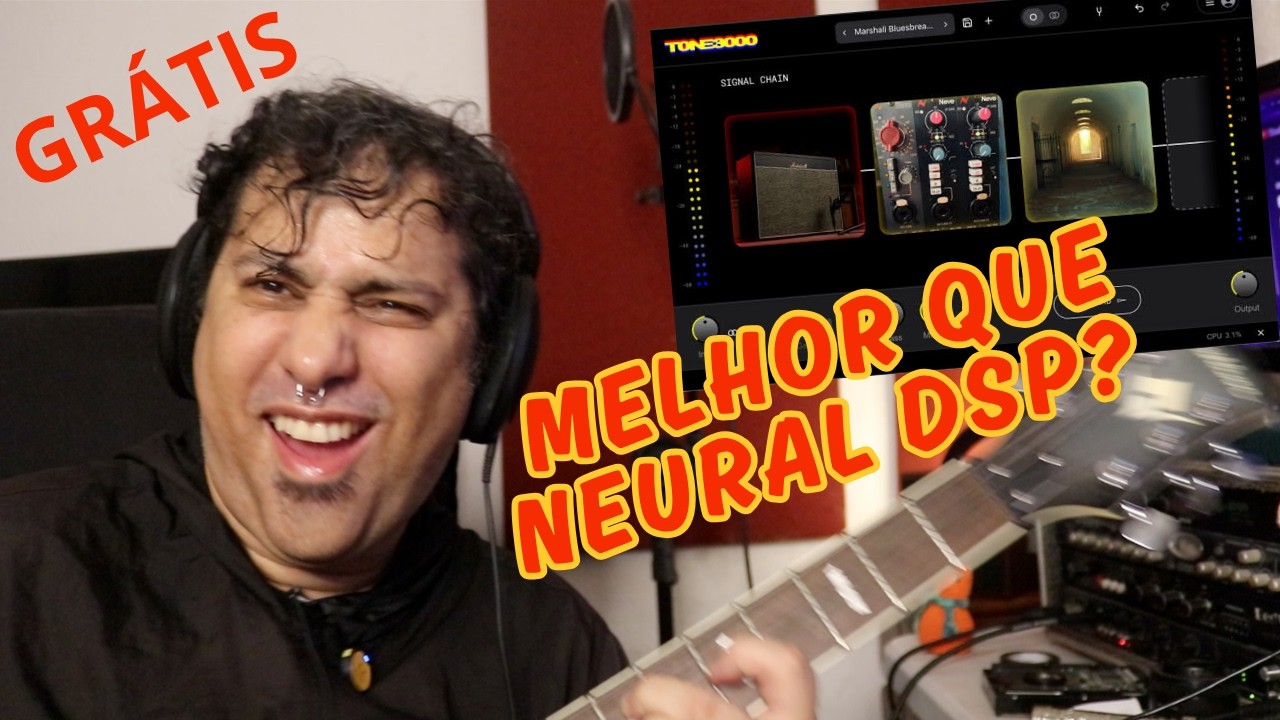
O TONE3000 lançou um plugin gratuito e de código aberto que dá acesso a mais de 700 mil capturas neurais e IRs, rodando a nova arquitetura NAM A2. Neste artigo você entende o que mudou na tecnologia, o que mostram os números de precisão e consumo de CPU e por que isso pressiona empresas como Neural DSP, IK Multimedia e Line 6. O vídeo abaixo traz um resumo, e o texto aprofunda cada ponto.
Resumo para quem tem pressa: em 1º de setembro de 2026 o TONE3000 lançou um plugin gratuito e de código aberto que dá acesso direto a mais de 700 mil capturas neurais e IRs. Ele roda a NAM A2, arquitetura lançada em 2 de junho de 2026, que é mais precisa que a geração anterior consumindo 30 a 40% menos CPU — e é eficiente o bastante para rodar nativamente em um chip de 3 dólares. Este artigo explica a tecnologia por dentro, os números, a metodologia dos testes e por que isso pressiona o modelo de negócio de Neural DSP, IK Multimedia e Line 6.
O que mudou no jogo
Simulação de amplificador sempre foi um problema de engenharia caro. Uma empresa contratava especialistas em DSP, media um amplificador real componente por componente, escrevia código que reproduzia aquele comportamento e vendia o resultado como plugin fechado. O ciclo levava anos e custava centenas de milhares de dólares por produto. O usuário recebia um conjunto fixo de timbres, e mais timbres significavam nova compra.
A modelagem neural inverteu essa lógica. Em vez de descrever o circuito, você grava o equipamento respondendo a um sinal de teste e treina uma rede neural para prever, amostra por amostra, o que aquele equipamento faria com qualquer entrada. O modelo não sabe o que é uma válvula. Ele aprende a função de transferência não linear do conjunto inteiro — pré, power amp, transformador, alto-falante, microfone, sala — a partir do áudio.
O Neural Amp Modeler (NAM), criado por Steve Atkinson, foi a implementação aberta dessa ideia. O TONE3000 (antigo ToneHunt) virou o repositório central dessas capturas. E a A2 é o ponto em que essa tecnologia aberta passou a ganhar dos sistemas proprietários nos próprios testes que a indústria usa para se avaliar.
Anatomia da A2: o que exatamente mudou
A A2 é resultado de uma parceria de seis meses entre o TONE3000 e Steve Atkinson. O time técnico foi formado por Woodbury Shortridge (cofundador e CTO do TONE3000), João Felipe Santos (engenheiro de machine learning e sistemas embarcados) e o próprio Atkinson.
Ainda é uma WaveNet?
Só no espírito. A A2 mantém a assinatura da WaveNet — convoluções causais dilatadas com conexões residuais e de skip — mas se afasta do artigo original de van den Oord e colegas em quase todo o resto.
A diferença estrutural mais importante: a WaveNet clássica é autorregressiva e generativa. Ela prevê uma distribuição de probabilidade para cada amostra a partir de todas as anteriores e gera áudio sequencialmente, o que é inviável em tempo real. A A2 é feedforward e determinística: mapeia áudio de entrada para áudio de saída em uma única passada. A saída também é diferente. A WaveNet emite uma distribuição categórica de 256 valores sobre amostras quantizadas em µ-law e treina maximizando log-verossimilhança; a A2 emite a amostra diretamente e treina com perda de regressão.
A troca que destravou tudo: tanh → leaky ReLU
A mudança isolada mais importante foi a função de ativação. A A1 usava tangente hiperbólica. A tanh é precisa, tanto no erro amostra a amostra quanto no comportamento em frequência, mas é cara de calcular em redes muito pequenas — e redes de amp modeling são minúsculas por definição, já que precisam rodar em buffers de dezenas de amostras.
Trocar por leaky ReLU (α = 0,01) liberou orçamento de CPU suficiente para aumentar a rede. O resultado, confirmado em muitos experimentos: uma rede maior com uma ativação mais barata é mais precisa pelo mesmo custo computacional. A ativação gated característica da WaveNet — tanh multiplicada por sigmoide — foi eliminada por completo.
Dilatações, degridding e campo receptivo
A WaveNet dobra as dilatações (1, 2, 4, 8… 512) e repete o padrão. A A2 usa um cronograma não dobrado, ajustado à mão e validado por otimização de hiperparâmetros: 1, 3, 7, 17, 41, 101, 239, distribuído em três pilhas de dilatação, num total de 23 camadas.
Entre a segunda e a terceira pilha entra um par de camadas de kernel largo (k = 15) que faz o que o time chama de degridding. O problema é conhecido em convoluções dilatadas empilhadas: elas tendem ao gridding, ou seja, posições da entrada que nunca são amostradas. Essas lacunas favorecem o acúmulo de harmônicos ímpares e produzem o ringing metálico que a galera reclamava em capturas de high gain. As camadas de degridding remisturam essas lacunas e reiniciam o campo receptivo efetivo. Isso só é possível porque a A2 permite misturar tamanhos de kernel dentro de um mesmo array de camadas — a A1 e a WaveNet original davam a cada pilha um kernel único.
O campo receptivo cresceu cerca de 50%: 6.332 amostras, aproximadamente 132 ms a 48 kHz, contra cerca de 4.100 amostras (~85 ms) na A1-Standard. Em termos práticos, o modelo enxerga uma janela maior do passado recente antes de prever a resposta. É essa memória curta que permite capturar comportamento dependente do tempo: sag de fonte, bloom de válvula entrando em breakup, e compressores com attack e release em ajustes realistas — que a A1 não modelava bem.
Por fim, a cabeça da rede mudou. Na A1 ela operava por amostra, como um waveshaper. Na A2 ela é convolucional, atuando sobre uma janela, o que a torna um misturador mais expressivo e ajuda a suavizar artefatos parecidos com aliasing, moldando a resposta de alta frequência diretamente.
Slimmable e packed training: um arquivo, dois tamanhos
Aqui está a sacada de engenharia que viabiliza o resto do ecossistema. Slimmable NAM é uma técnica desenvolvida por Atkinson que permite que uma única rede treinada rode em larguras diferentes, produzindo variantes de tamanho sem retreinar. O artigo, Slimmable NAM: Neural Amp Models with adjustable runtime computational cost, foi aceito no workshop de IA para Música do NeurIPS 2025 (arxiv.org/abs/2511.07470).
A A2 usa uma variante chamada packed training. Na abordagem slimmable original, o tamanho menor é uma sub-fatia de canais do maior, e compartilhar pesos entre os dois custa precisão. Na versão packed, cada tamanho recebe seu próprio bloco de pesos dentro do mesmo modelo: eles treinam juntos, mas as camadas são estruturadas em blocos de modo que cada tamanho só lê e escreve nos próprios canais, com uma máscara zerando os pesos cruzados a cada passo do otimizador. Nenhum dos dois precisa se comprometer pelo outro.
Resultado: uma rede de 8 canais (A2-Full) e uma de 3 canais (A2-Lite) empacotadas em um único arquivo. Você baixa uma vez; o dispositivo escolhe o que a CPU dele aguenta.
A receita de treino
Foram mais de dez mil treinamentos em experimentos de HPO, variando kernels, padrões de dilatação, contagem de canais, ativações e escolhas arquiteturais. A perda final ficou em MSE mais um termo pequeno de MRSTFT (transformada de Fourier de curto tempo em múltiplas resoluções) para manter o comportamento em frequência honesto; a maioria das funções de perda novas testadas foi descartada. O ESR é usado como validação para escolher o melhor checkpoint. Os dados de treino são normalizados para uma referência fixa de -18 dB RMS — o nível para o qual a HPO foi calibrada — e o reescalonamento é dobrado de volta na escala da cabeça, o que mantém a saída nivelada sem passo extra na inferência e faz todo tom treinar sob as mesmas condições.
Também foram exploradas e descartadas: arquiteturas base alternativas (LSTM e um modelo Hammerstein-Wiener sob medida), meia dúzia de ativações, camadas FiLM, convolução agrupada, gargalos nas camadas WaveNet, EMA de pesos, quantização agressiva e destilação. Quando os resultados empatavam, a simplicidade ganhava.
Detalhe folclórico para quem gosta: mais de 42 arquiteturas chegaram a estágio de candidata a produção, e o time passou a batizá-las com nomes de personagens de O Senhor dos Anéis. A final foi entre Boromir e Legolas. Boromir venceu.
Os números
Precisão
Quando o TONE3000 retreinou a biblioteca inteira de A1 para A2, comparou o ESR de cada modelo antes e depois. A mediana caiu praticamente pela metade: de 0,0062 na A1-Standard para 0,0033 na A2-Full (menor é melhor). Isso significa que o modelo A2 acompanha o equipamento real mais de perto, amostra por amostra.
Eficiência
| Métrica | A1-Standard | A2-Full | A2-Lite |
|---|---|---|---|
| Canais | — | 8 | 3 |
| Campo receptivo | ~4.100 amostras (~85 ms) | 6.332 amostras (~132 ms) | 6.332 amostras (~132 ms) |
| Custo de CPU | referência | 30–40% menor | fração do orçamento |
| Instâncias simultâneas (MacBook Apple Silicon) | — | ~64 | ~200 |
| Alvo | DAW | DAW e hardware com folga | pedaleiras e amps embarcados |
Você roda três A2-Full pelo custo de CPU de duas A1-Standard, com precisão maior. E a A2-Lite roda a 50% de CPU em um ARM Cortex-M7 de 600 MHz — o chip que custa cerca de 3 dólares por unidade em compras de volume e que está dentro de boa parte das pedaleiras de mercado de massa. Mesmo nesse tamanho reduzido, a A2-Lite ainda superou todos os modeladores comerciais testados, e nos testes cegos ficou lado a lado com a A1-Standard.
A parte que quase ninguém comenta: o motor de inferência
Metade do ganho de eficiência não veio da arquitetura, e sim de engenharia de inferência. A operação quente numa WaveNet é a convolução 1×1 que mistura canais — na prática, uma multiplicação de matriz pequena, executada uma vez por camada por bloco. Bibliotecas matemáticas de uso geral são otimizadas para matrizes grandes e desperdiçam tempo em setup e alocações temporárias nos tamanhos minúsculos da NAM.
O caminho rápido do NeuralAmpModelerCore troca isso por kernels totalmente desenrolados, residentes em registrador, dimensionados para as contagens de canais da A2. Em um Apple M5, isso levou a A2-Lite de um fator de tempo real de 50x no caminho antigo com Eigen para 316x. Cerca de 6 vezes mais rápido no mesmo modelo, só com engenharia de inferência.
No embarcado a solução foi outra: um motor em C puro, sem dependências, publicado como referência. As otimizações são de baixo nível e cada uma só ficou porque um microbenchmark provou que compensava no Cortex-M7 — multiplicações de matriz desenroladas à mão, camadas fundidas que mantêm valores intermediários em registradores, ativações por tabela de lookup no lugar de exp, pesos fixados em memória fortemente acoplada com os ring buffers em SRAM cacheada, e buffers circulares de potência de 2 para dar tempo constante por bloco. No Daisy Seed (Cortex-M7 a 480 MHz), a A2-Lite roda em tempo real com margem.
A metodologia do teste cego (e como interpretá-la)
Essa é a parte que separa uma alegação de marketing de uma evidência discutível. O TONE3000 rodou um teste cego formal usando MUSHRA (Multiple Stimuli with Hidden Reference and Anchor), a metodologia padrão para avaliação de qualidade percebida de áudio, usada por emissoras como BBC e EBU.
- Mais de 1.000 participantes e mais de 100 mil avaliações.
- Em cada rodada, o participante ouvia primeiro a gravação do equipamento real como referência, e depois pontuava versões anonimizadas do mesmo timbre numa escala de 0 a 100.
- Os modelos comparados: A2-Full, A2-Lite, A1-Standard, A1-Nano, Neural Capture V2 da Neural DSP, ToneX da IK Multimedia e Proxy da Line 6.
- Conforme a metodologia, dois clipes de cada rodada eram controles de qualidade: uma referência oculta (duplicata do original, que deveria pontuar alto) e uma âncora filtrada em passa-baixa (que deveria pontuar baixo). Participantes que pontuaram a referência oculta muito baixo ou a âncora muito alto foram descartados.
- O teste quantitativo paralelo comparou saídas contra gravações reais usando ESR, MAE, LOG_MEL e MRSTFT, em 39 timbres distintos — de cleans Fender a um Neve 1073, a um Mesa Boogie Dual Rectifier no talo, com um fuzz de oitava para estressar distorção extrema. As pontuações alimentaram um rating Elo bayesiano.
- Os testes foram feitos em março de 2026, com as versões mais recentes dos concorrentes disponíveis então.
A ressalva honesta: o teste é do próprio fabricante. Isso não o invalida — MUSHRA com pós-triagem por âncora é metodologia séria, e o time abriu o código do teste e os dados brutos justamente convidando à replicação e à contestação. Mas quem faz o teste escolhe o conjunto de avaliação, as versões dos concorrentes e as condições. Trate como um sinal forte, não como veredito. E lembre que o teste avalia áudio gravado: uma parte grande do que faz um amplificador parecer certo acontece sob os dedos, em tempo real, e nenhuma avaliação de material gravado captura isso.
Por que isso pressiona os gigantes
A vantagem estrutural não é técnica, é econômica. Compare os dois modelos:
| Modelo proprietário | NAM A2 / TONE3000 | |
|---|---|---|
| Quem produz o conteúdo | a empresa, com equipe de DSP | a comunidade, de graça |
| Crescimento do acervo | por ciclo de produto | diário, sem atualização de software |
| Portabilidade do timbre | preso ao ecossistema da marca | arquivo aberto, roda onde houver suporte |
| Licença da tecnologia | fechada | MIT, uso comercial livre |
| Custo para o usuário | US$ 100+ por pacote fixo | zero |
A analogia certa é IR ou MIDI. Ninguém compra um “MIDI da Yamaha” que só toca em teclado Yamaha. O NAM está tentando ocupar essa posição para timbre: um protocolo, não um produto. Quando o formato é aberto e a biblioteca é comunitária, a empresa que gastou dois anos modelando um amplificador específico está competindo com alguém que capturou o mesmo amplificador num fim de semana e publicou de graça.
O efeito já aparece no hardware. HeadRush levou o TONE3000 para toda a linha de multiefeitos, o Darkglass Anagram conecta direto à plataforma, e Blackstar, Hotone, Mooer e NUX estão no ecossistema, com Valeton a caminho. A API do TONE3000 permite que o fabricante ofereça a biblioteca inteira dentro do próprio produto, e cada tom novo publicado fica instantaneamente disponível em todos os aparelhos conectados.
Vale registrar a crítica técnica que o TONE3000 faz a uma prática comum do setor: várias marcas convertem modelos NAM A1 para formatos proprietários para rodar nos próprios chips. Esses modelos destilados não são NAM de verdade e não preservam a mesma precisão. A existência da A2-Lite tira a justificativa técnica dessa conversão, já que agora dá para rodar NAM nativamente em chip barato.
O plugin: o que ele resolve na prática
Até o lançamento, usar um timbre do TONE3000 era um ritual: achar no site, baixar o arquivo, descompactar, organizar numa pasta, apontar o carregador NAM de terceiro para o diretório. Testar outro timbre significava repetir tudo. Muita gente experimentou NAM, esbarrou nesse atrito e desistiu antes de ouvir a primeira captura.
O plugin elimina os passos intermediários. Você navega centenas de milhares de capturas e IRs — cabeçotes, gabinetes, conjuntos amp + cab, pedais, outboard, espaços acústicos e capturas experimentais — de dentro da interface. Com login na conta, seus favoritos, recentes, criados e privados aparecem lá.
Especificações:
- Formatos: VST3, AU, AAX, CLAP e LV2, mais aplicativo standalone (sem DAW).
- Sistemas: macOS (Apple Silicon e Intel), Windows e Linux.
- Chains: monta uma cadeia de sinal completa empilhando capturas e IRs sem limite fixo — por exemplo, um EP-3 na frente de um JCM800 empurrado, mais um drive, mais o IR de sua escolha.
- Estéreo com duas cadeias simultâneas, panorâmicas independentes.
- Código aberto, disponível em github.com/tone-3000/tone3000-plugin.
- Sem licença, sem compra, sem upsell de pacotes de timbre.
Migração e compatibilidade: leia antes de reclamar
A A2 não é retrocompatível. É uma arquitetura nova, não uma atualização drop-in. Fabricantes que já suportavam A1 precisam atualizar as integrações, e a expectativa do TONE3000 é de suporte amplo no ecossistema até o fim de 2026.
Do lado do usuário, a transição foi feita pela plataforma. A biblioteca inteira de modelos A1 foi retreinada, com duas rotas: onde havia os dados originais de treino, os modelos A2 foram treinados do zero a partir da gravação do equipamento; onde não havia, o TONE3000 gerou dados sintéticos a partir do modelo A1 e treinou em cima. Estes últimos aparecem marcados como “Convert” e soam equivalentes ao A1, mas rodam muito mais leves. Ficaram de fora apenas modelos com zero downloads e mais de 60 dias, e modelos com dados de treino malformados.
Modelos A1 continuam acessíveis via filtro Técnico → “A1 – Legacy” na busca. Você não precisa separar arquiteturas em packs diferentes: cada tone pack suporta A2, A1 e arquiteturas customizadas ao mesmo tempo, e o aplicativo carrega o que souber ler. Capturas feitas pelo método dry/wet continuam funcionando igual.
Para quem constrói: como adicionar suporte A2
- Software: atualize para o NeuralAmpModelerCore v0.5.2 ou superior. É o motor de inferência em C++, e a v0.5.2 é a release que adiciona A2. O caminho rápido vem ligado por padrão pela opção de CMake
NAM_ENABLE_A2_FAST, que roteia modelos com formato A2 para inferência otimizada à mão. - Embarcado: um motor em C++ apoiado em biblioteca matemática genérica é péssimo encaixe para um microcontrolador com FPU escalar e algumas centenas de KB de RAM. Use a referência em C puro, sem dependências, publicada em github.com/tone-3000/nam-pedal, que demonstra A2 rodando no Daisy Seed.
- Formato binário: no embarcado, use
.namb— representação binária compacta de um modelo NAM, com app companheiro para conversão sem perda de qualidade e transferência por USB ou Bluetooth. - Treinador: github.com/sdatkinson/neural-amp-modeler. Tudo sob licença MIT, livre para uso, modificação e envio em produtos comerciais, sem taxa.
- API: a API do TONE3000 permite navegar e carregar a biblioteca dentro do seu produto. Hoje é preciso pedir A2 explicitamente nas chamadas; A1 segue como padrão por retrocompatibilidade, mas isso vai mudar.
Onde a tecnologia ainda tem limites
Um artigo que só elogia não serve para nada. Os limites reais:
- Captura é um instantâneo. Cada arquivo representa um ponto específico dos controles do equipamento. Não existem knobs paramétricos de verdade: mudar o ganho significa outra captura. Modeladores proprietários com modelagem de componentes oferecem controles contínuos.
- A qualidade depende de quem capturou. Uma biblioteca comunitária de 700 mil itens tem variação enorme de qualidade. Ruído na sala, nível de entrada errado, reamp mal calibrado — tudo isso vira parte do modelo. Curadoria é problema seu.
- Fragmentação de suporte. Como A2 quebra compatibilidade, por um tempo vamos conviver com aparelhos que leem só A1, aparelhos que convertem para formato próprio e aparelhos com A2 nativo.
- Métricas não são a mão. ESR baixo e boa pontuação MUSHRA descrevem correspondência de áudio gravado. Resposta ao toque, dinâmica sob o pick e o modo como o amplificador reage ao volume da guitarra são coisas que essas avaliações não medem diretamente. O próprio time do TONE3000 diz isso.
🤖 Produção Musical e o Futuro: Inteligência Artificial
Tudo que você acabou de ler é rede neural aplicada a áudio: uma máquina aprendendo o comportamento de um amplificador a partir de gravações. E isso é só uma frente. A Inteligência Artificial já está mudando como criamos, mixamos e masterizamos. Saia na frente e domine essas ferramentas hoje mesmo.
Conclusão
O que aconteceu em 2026 não foi apenas uma arquitetura melhor. Foi a combinação de três coisas que raramente andam juntas: precisão que ganha dos sistemas fechados em teste cego formal, eficiência que coloca a tecnologia num chip de 3 dólares, e licença MIT que permite qualquer fabricante embarcar isso sem pagar nada. Some a isso uma biblioteca comunitária que dobrou de tamanho em três meses e um plugin gratuito que remove o último atrito de uso, e você tem uma pressão que nenhum ciclo de produto proprietário consegue acompanhar.
Se você produz em casa, a recomendação prática é simples: instale o plugin, carregue meia dúzia de capturas do equipamento que você conhece de ouvido, e julgue com a sua mão. É o único teste que importa de verdade.
Perguntas frequentes
Preciso pagar alguma coisa?
Não. O plugin, o motor A2 e o acesso à biblioteca são gratuitos, e o código é aberto. Não existe licença para carregar e tocar timbres.
Qual a diferença entre NAM e A2?
NAM é o framework aberto de modelagem neural, com as ferramentas para treinar um modelo a partir de uma gravação e rodá-lo em tempo real; ele suporta várias arquiteturas, de modelos lineares a LSTMs e WaveNets. A2 é uma arquitetura específica criada dentro do NAM, pensada para ser um padrão aberto adotado pela indústria.
Preciso escolher entre A2-Full e A2-Lite?
Normalmente não. É um único arquivo com os dois tamanhos, e o aplicativo ou aparelho escolhe conforme o orçamento de CPU. Alguns permitem escolher manualmente.
Preciso retreinar minhas capturas antigas?
Não. A biblioteca foi retreinada pela plataforma, com as exceções já citadas.
Vale mais que um Quad Cortex ou um ToneX?
Depende do que você compra. Hardware dedicado vende integração, latência controlada, robustez de palco e suporte. O que a A2 muda é que a qualidade da captura deixou de ser o diferencial que justifica o ecossistema fechado.
Links úteis: plugin · guia técnico completo da A2 · repositórios no GitHub
Deixe um comentário